Pix2Text (P2T) V0.2 发布
Pix2Text (P2T) 的目标是成为 Mathpix 的 免费开源 Python 替代工具,完成与 Mathpix 类似的功能。 用户输入一张包含文字和数学公式的图片,P2T 识别出图片中的文字和数学公式的 LaTeX 表示,最终返回纯文本形式的混合识别结果。 这些结果可以直接用于 LaTeX 文档的编写,也可以用于其他的文本编辑器,比如 Word、Markdown 等。 可参考P2T之前的介绍文章:Pix2Text: 替代 Mathpix 的免费 Python 开源工具 。
Pix2Text (P2T) V0.2 已经可以识别既包含文字又包含数学公式的混合图片,已经可以完成 Mathpix 的核心功能了。 旧的P2T只能识别要么是文字,要么是数学公式的单类型图片。依托于 CnSTD V1.2.1,新版 P2T V0.2 能够识别混合图片,比如这个图片:
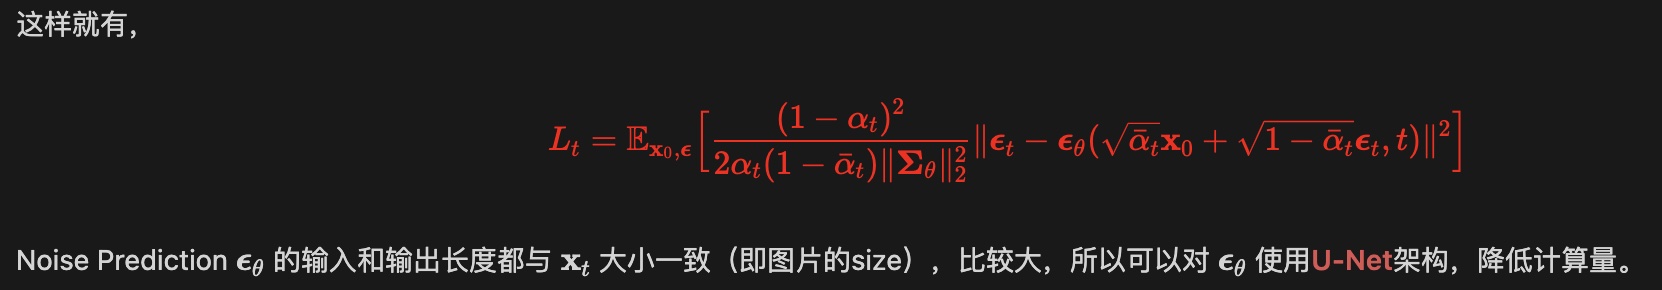
P2T V0.2 可以识别为:
这样就有

$$
{\cal L}_{t}=\mathbb{E}_{x_{0},\epsilon}\biggl[{\frac{(1-\alpha_{t})^{2}}{2\alpha_{t}(1-\tilde{\alpha}_{t})|\mathbf{E}_\theta||_{2}^{2}}}||\epsilon_{t}-\epsilon_{\theta}({\sqrt{\tilde{\alpha}_{t}}}\mathbf{x}_{0}+{\sqrt{1-\tilde{\alpha}_{t}}}\epsilon_{t},t)|^{2}\biggr]
$$

Noise Prediction $\mathbb{C}_{\theta}$ 的输入和输出长度都与 $\mathbf{x}_{t}$ 大小一致(即图片的size),比较大,所以可以对∈。使用U-Net架构,降低计算量。
P2T V0.2 的代码,以及预训练好的模型,都已经开源,欢迎大家使用。和 Mathpix 相比,P2T V0.2 的识别准确率和识别速度都还有很大提升空间,也请大家多包容,后续我们会继续推进相关优化。
网页版开放免费试用
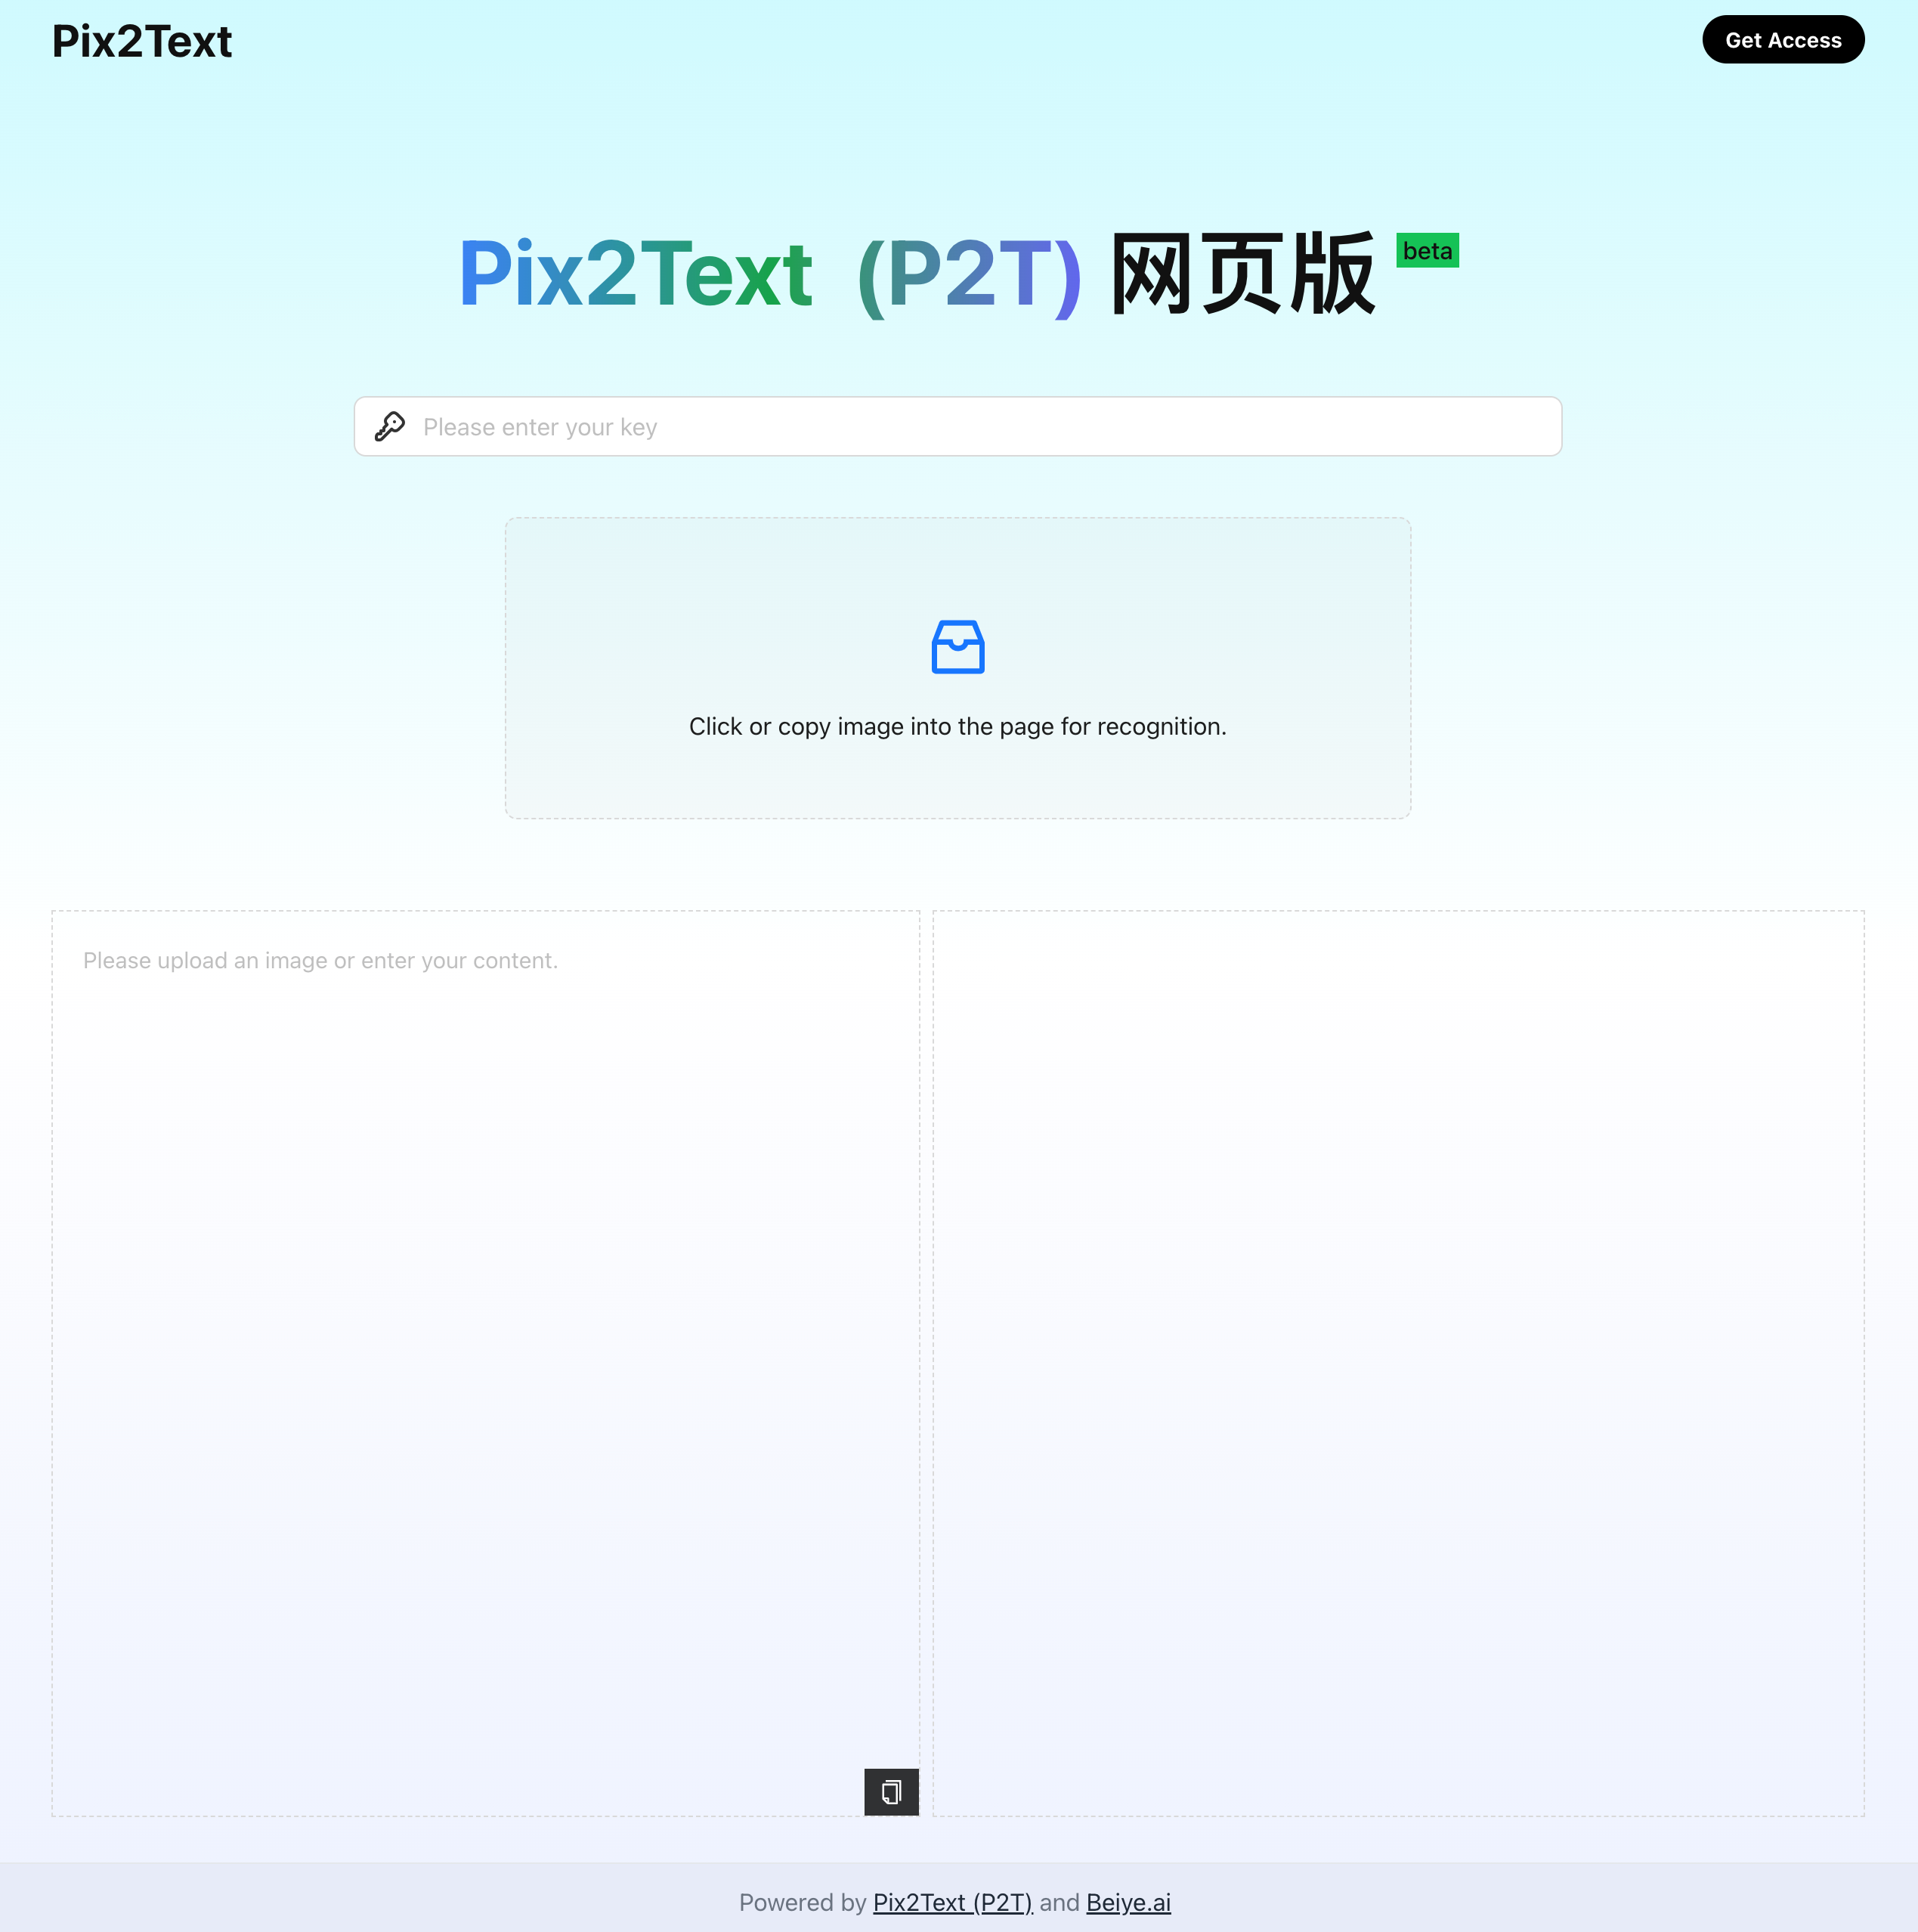
P2T作为Python包,对于不熟悉Python的朋友还是太不友好,所以我们也开发了 P2T网页版 。
在第一次使用时需要先输入我们提供的 key,之后就可以直接把图片Ctrl-V丢进网页得到P2T的识别结果。
如果识别结果存在问题,可以通过网页左下侧框编辑识别效果,通过右下侧框可以实时看到编辑后的效果。
Warning
因为服务器资源限制,网页版前期只开放少量
key供有需要的朋友使用,优先在校师生( MathPix 每月要5美元,对在校生来说还是蛮贵的)。
欢迎感兴趣的朋友扫码加入微信交流群,我们会在群里公布获取免费 key 的方式以及后续进展。
接下来介绍 P2T V0.2 作为Python包的基础使用方法,更详细的说明请转到项目主页 Pix2Text 。
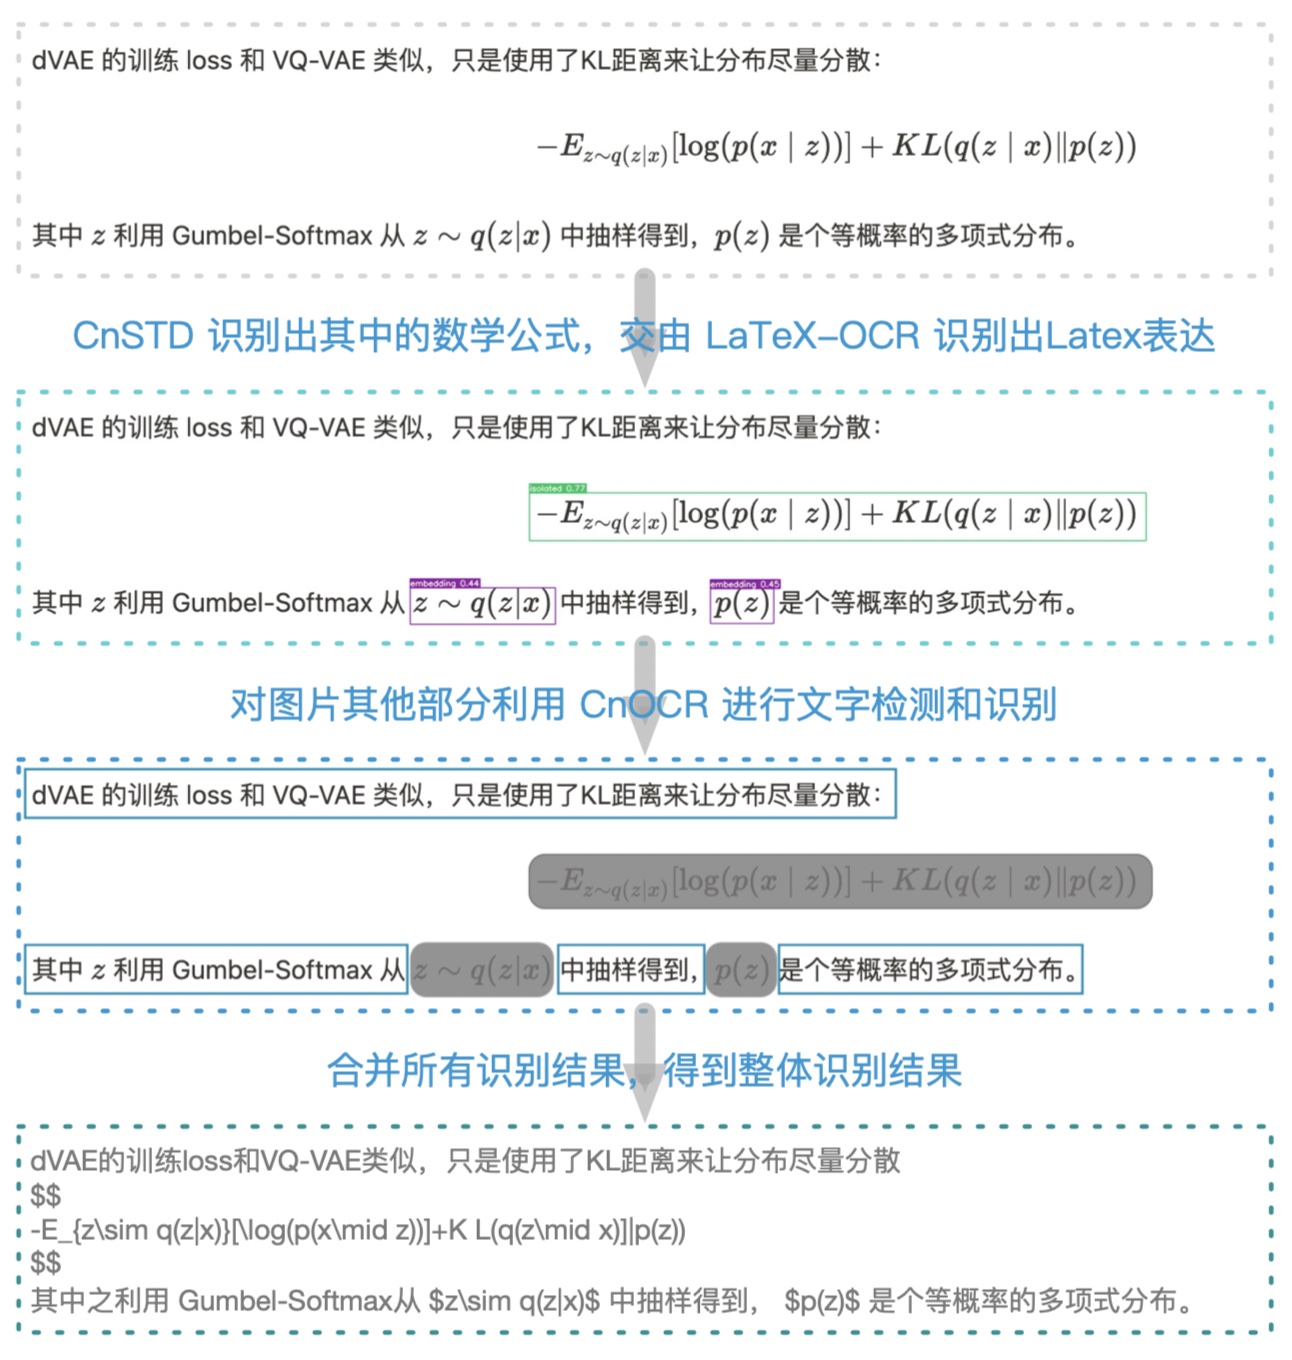
P2T V0.2 使用开源工具 CnSTD 检测出图片中数学公式所在位置, 再交由 LaTeX-OCR 识别出各对应位置数学公式的Latex表示。 图片的剩余部分再交由 CnOCR 进行文字检测和文字识别。 最后 P2T 合并所有识别结果,获得最终的图片识别结果。感谢这些开源工具。
P2T V0.2 核心流程见下图(文字识别支持中文和英文):
使用说明
调用很简单,以下是示例:
from pix2text import Pix2Text

img_fp = './docs/examples/formula.jpg'
p2t = Pix2Text(analyzer_config=dict(model_name='mfd'))
outs = p2t(img_fp, resized_shape=600)  # 也可以使用 `p2t.recognize(img_fp)` 获得相同的结果
print(outs)
# 如果只需要识别出的文字和Latex表示,可以使用下面行的代码合并所有结果
only_text = '\n'.join([out['text'] for out in outs])
返回结果 out_text 是个 dict,其中 key position 表示位置信息,type 表示类别信息,而 text 表示识别的结果。具体见下面的接口说明。
示例
安装
嗯,顺利的话一行命令即可。
pip install pix2text
安装速度慢的话,可以指定国内的安装源,如使用豆瓣源:
pip install pix2text -i https://pypi.doubanio.com/simple
如果是初次使用OpenCV,那估计安装都不会很顺利,bless。
Pix2Text 主要依赖 CnSTD>=1.2.1、CnOCR>=2.2.2.1 ,以及 LaTeX-OCR 。如果安装过程遇到问题,也可参考它们的安装说明文档。
Warning
如果电脑中从未安装过
PyTorch,OpenCVpython包,初次安装可能会遇到不少问题,但一般都是常见问题,可以自行百度/Google解决。
模型下载
安装好 Pix2Text 后,首次使用时系统会自动下载 模型文件,并存于 ~/.pix2text目录(Windows下默认路径为 C:\Users\<username>\AppData\Roaming\pix2text)。
Note
如果已成功运行上面的示例,说明模型已完成自动下载,可忽略本节后续内容。
对于分类模型,系统会自动下载模型mobilenet_v2.zip文件并对其解压,然后把解压后的模型相关目录放于~/.pix2text目录中。如果系统无法自动成功下载mobilenet_v2.zip文件,则需要手动从 cnstd-cnocr-models/pix2text 下载此zip文件并把它放于 ~/.pix2text目录。如果下载太慢,也可以从 百度云盘 下载, 提取码为 ` p2t0`。
对于 LaTeX-OCR ,系统同样会自动下载模型文件并把它们存放于~/.pix2text/formula目录中。如果系统无法自动成功下载这些模型文件,则需从 百度云盘 下载文件 weights.pth 和 image_resizer.pth, 并把它们存放于~/.pix2text/formula目录中;提取码为 ` p2t0`。
接口说明
类初始化
主类为 Pix2Text ,其初始化函数如下:
class Pix2Text(object):

    def __init__(
        self,
        *,
        analyzer_config: Dict[str, Any] = None,
        clf_config: Dict[str, Any] = None,
        general_config: Dict[str, Any] = None,
        english_config: Dict[str, Any] = None,
        formula_config: Dict[str, Any] = None,
        thresholds: Dict[str, Any] = None,
        device: str = 'cpu',  # ['cpu', 'cuda', 'gpu']
        **kwargs,
    ):
其中的各参数说明如下:
-
analyzer_config(dict): 分类模型对应的配置信息;默认为None,表示使用默认配置(使用MFD Analyzer):{ 'model_name': 'mfd' # 可以取值为 'mfd'(MFD),或者 'layout'(版面分析) } clf_config(dict): 分类模型对应的配置信息;默认为None,表示使用默认配置:{ 'base_model_name': 'mobilenet_v2', 'categories': IMAGE_TYPES, 'transform_configs': { 'crop_size': [150, 450], 'resize_size': 160, 'resize_max_size': 1000, }, 'model_dir': Path(data_dir()) / 'clf', 'model_fp': None # 如果指定,直接使用此模型文件 }-
general_config(dict): 通用模型对应的配置信息;默认为None,表示使用默认配置:{} -
english_config(dict): 英文模型对应的配置信息;默认为None,表示使用默认配置:{'det_model_name': 'en_PP-OCRv3_det', 'rec_model_name': 'en_PP-OCRv3'} -
formula_config(dict): 公式识别模型对应的配置信息;默认为None,表示使用默认配置:{ 'config': LATEX_CONFIG_FP, 'checkpoint': Path(data_dir()) / 'formular' / 'weights.pth', 'no_resize': False } -
thresholds(dict): 识别阈值对应的配置信息;默认为None,表示使用默认配置:{ 'formula2general': 0.65, # 如果识别为 `formula` 类型,但得分小于此阈值,则改为 `general` 类型 'english2general': 0.75, # 如果识别为 `english` 类型,但得分小于此阈值,则改为 `general` 类型 } -
device(str): 使用什么资源进行计算,支持['cpu', 'cuda', 'gpu'];默认为cpu **kwargs(): 预留的其他参数;目前未被使用
识别类函数
通过调用类 Pix2Text 的类函数 .recognize() 完成对指定图片进行识别。类函数 .recognize() 说明如下:
    def recognize(
        self, img: Union[str, Path, Image.Image], use_analyzer: bool = True, **kwargs
    ) -> List[Dict[str, Any]]:
其中的输入参数说明如下:
img(strorImage.Image):待识别图片的路径,或者利用Image.open()已读入的图片Image。use_analyzer(bool):是否使用 Analyzer (MFD or Layout);False表示把图片看成纯文本或者纯图片处理,相当于 P2T V0.1.* 的效果。Default:True。kwargs: 保留字段,可以包含以下值,resized_shape(int): 把图片宽度resize到此大小再进行处理;默认值为700;save_analysis_res(str): 把解析结果图片存在此文件中;默认值为None,表示不存储;embed_sep(tuple): embedding latex的前后缀;只针对使用MFD时才有效;默认值为(' $', '$ ');isolated_sep(tuple): isolated latex的前后缀;只针对使用MFD时才有效;默认值为('$$\n', '\n$$')。
返回结果为列表(list),列表中的每个元素为dict,包含如下 key:
type:识别出的图像类别;- 当开启Analyzer时(
use_analyzer==True),取值为text(纯文本)、isolated(独立行的数学公式) 或者text-embed(文本行中包含了嵌入式的数学公式); - 当未开启Analyzer时(
use_analyzer==False),取值为formula(纯数学公式)、english(纯英文文字)、general(纯文字,可能包含中英文);
- 当开启Analyzer时(
text:识别出的文字或Latex表达式;position:所在块的位置信息,np.ndarray, with shape of[4, 2]。
Pix2Text 类也实现了 __call__() 函数,其功能与 .recognize() 函数完全相同。所以才会有以下的调用方式:
from pix2text import Pix2Text

img_fp = './docs/examples/formula.jpg'
p2t = Pix2Text(analyzer_config=dict(model_name='mfd'))
outs = p2t(img_fp, resized_shape=600)  # 也可以使用 `p2t.recognize(img_fp)` 获得相同的结果
print(outs)
# 如果只需要识别出的文字和Latex表示,可以使用下面行的代码合并所有结果
only_text = '\n'.join([out['text'] for out in outs])
脚本使用
P2T 包含了以下命令行工具。
对单张图片或单个文件夹中的图片进行识别
使用命令 p2t predict 预测单个文件或文件夹中所有图片,以下是使用说明:
$ p2t predict -h
Usage: p2t predict [OPTIONS]

  模型预测

Options:
  --use-analyzer / --no-use-analyzer
                                  是否使用 MFD 或者版面分析 Analyzer  [default: use-
                                  analyzer]
  -a, --analyzer-name [mfd|layout]
                                  使用哪个Analyzer,MFD还是版面分析  [default: mfd]
  -d, --device TEXT               使用 `cpu` 还是 `gpu` 运行代码,也可指定为特定gpu,如`cuda:0`
                                  [default: cpu]
  --resized-shape INTEGER         把图片宽度resize到此大小再进行处理  [default: 700]
  -i, --img-file-or-dir TEXT      输入图片的文件路径或者指定的文件夹  [required]
  --save-analysis-res TEXT        把解析结果存储到此文件或目录中(如果"--img-file-or-dir"
                                  为文件/文件夹,则"--save-analysis-res"
                                  也应该是文件/文件夹)。取值为 `None` 表示不存储 [default: None]
  -l, --log-level TEXT            Log Level, such as `INFO`, `DEBUG`
                                  [default: INFO]
  -h, --help                      Show this message and exit.
HTTP服务
Pix2Text 加入了基于 FastAPI 的HTTP服务。开启服务需要安装几个额外的包,可以使用以下命令安装:
$ pip install pix2text[serve]
安装完成后,可以通过以下命令启动HTTP服务(-p 后面的数字是端口,可以根据需要自行调整):
$ p2t serve -p 8503
p2t serve 命令使用说明:
$ p2t serve -h
Usage: p2t serve [OPTIONS]

  开启HTTP服务。

Options:
  -H, --host TEXT     server host  [default: 0.0.0.0]
  -p, --port INTEGER  server port  [default: 8503]
  --reload            whether to reload the server when the codes have been
                      changed
  -h, --help          Show this message and exit.
服务开启后,可以使用以下方式调用服务。
命令行
比如待识别文件为 docs/examples/mixed.jpg,如下使用 curl 调用服务:
$ curl -F image=@docs/examples/mixed.jpg --form 'use_analyzer=true' --form 'resized_shape=600' http://0.0.0.0:8503/pix2text
Python
使用如下方式调用服务,参考文件 scripts/try_service.py:
import requests

url = 'http://0.0.0.0:8503/pix2text'

image_fp = 'docs/examples/mixed.jpg'
data = {
    "use_analyzer": True,
    "resized_shape": 600,
    "embed_sep": " $,$ ",
    "isolated_sep": "$$\n, \n$$"
}
files = {
    "image": (image_fp, open(image_fp, 'rb'))
}

r = requests.post(url, data=data, files=files)

outs = r.json()['results']
only_text = '\n'.join([out['text'] for out in outs])
print(f'{only_text=}')
其他语言
请参照 curl 的调用方式自行实现。
脚本运行
脚本 scripts/screenshot_daemon.py 实现了自动对截屏图片调用 Pixe2Text 进行公式或者文字识别。这个功能是如何实现的呢?
以下是具体的运行流程(请先安装好 Pix2Text):
-
找一个喜欢的截屏软件,这个软件只要支持把截屏图片存储在指定文件夹即可。比如Mac下免费的 Xnip 就很好用。
-
除了安装Pix2Text外,还需要额外安装一个Python包 pyperclip,利用它把识别结果复制进系统的剪切板:
$ pip install pyperclip -
下载脚本文件 scripts/screenshot_daemon.py 到本地,编辑此文件
"SCREENSHOT_DIR"所在行(第17行),把路径改为你的截屏图片所存储的目录。 -
运行此脚本:
$ python scripts/screenshot_daemon.py
好了,现在就用你的截屏软件试试效果吧。截屏后的识别结果会写入电脑剪切板,直接 Ctrl-V / Cmd-V 即可粘贴使用。
官方代码库:

